Atak pisany wierszem? Analizy pokazują luki w zabezpieczeniach modeli AI
Badania F5 Labs wskazują na luki w zabezpieczeniach modeli językowych. W nowych scenariuszach skuteczność ochrony spada z 90% do 33,8%. Wyzwaniem jest brak odporności na nieznane konteksty oraz techniki manipulacji znaczeniem, takie jak poezja adwersarialna, o czym informują eksperci firmy F5.

Według danych z grudniowej edycji raportu Comprehensive AI Security Index (CASI), wzrost wydajności modeli językowych nie zawsze przekłada się na wyższy poziom ich odporności. Na czele zestawienia pod względem bezpieczeństwa znalazł się model Claude Opus 4.5. Z kolei Gemini 3, mimo wysokich not za ogólne zdolności, uzyskał w kategorii bezpieczeństwa około 50 punktów.
Podobną tendencję odnotowano w przypadku GPT-5.1, który poprawił wydajność ogólną, ale jednocześnie stracił cztery punkty w zakresie odporności. Eksperci wskazują, że nawet niewielkie zmiany architektoniczne lub próby redukcji nadmiernej werbalności modelu mogą osłabiać jego mechanizmy obronne przed próbami przełamania zabezpieczeń.
Problem przeuczenia systemów ochronnych
Analizy systemów typu „AI safety guardrails” pokazują, że ich wysoka skuteczność dotyczy głównie znanych zagrożeń. W badaniu obejmującym dziesięć modeli od dostawców takich jak Meta, Google, IBM czy NVIDIA, sprawdzono reakcje na ponad 1,4 tysiąca promptów. Wyniki ujawniły, że odporność ta bywa pozorna. Przykładem jest model Qwen3Guard-8B, którego dokładność spadła z 91% do 33,8% podczas konfrontacji z nowymi zapytaniami.
Bartłomiej Anszperger, Solution Engineering Manager CEE w F5, tłumaczy, że zjawisko to sugeruje przeuczenie do publicznie dostępnych zbiorów testowych. Systemy uczą się rozpoznawać konkretne wzorce, ale nie radzą sobie z ich kreatywnymi modyfikacjami.
Manipulacja językiem i poezja adwersarialna
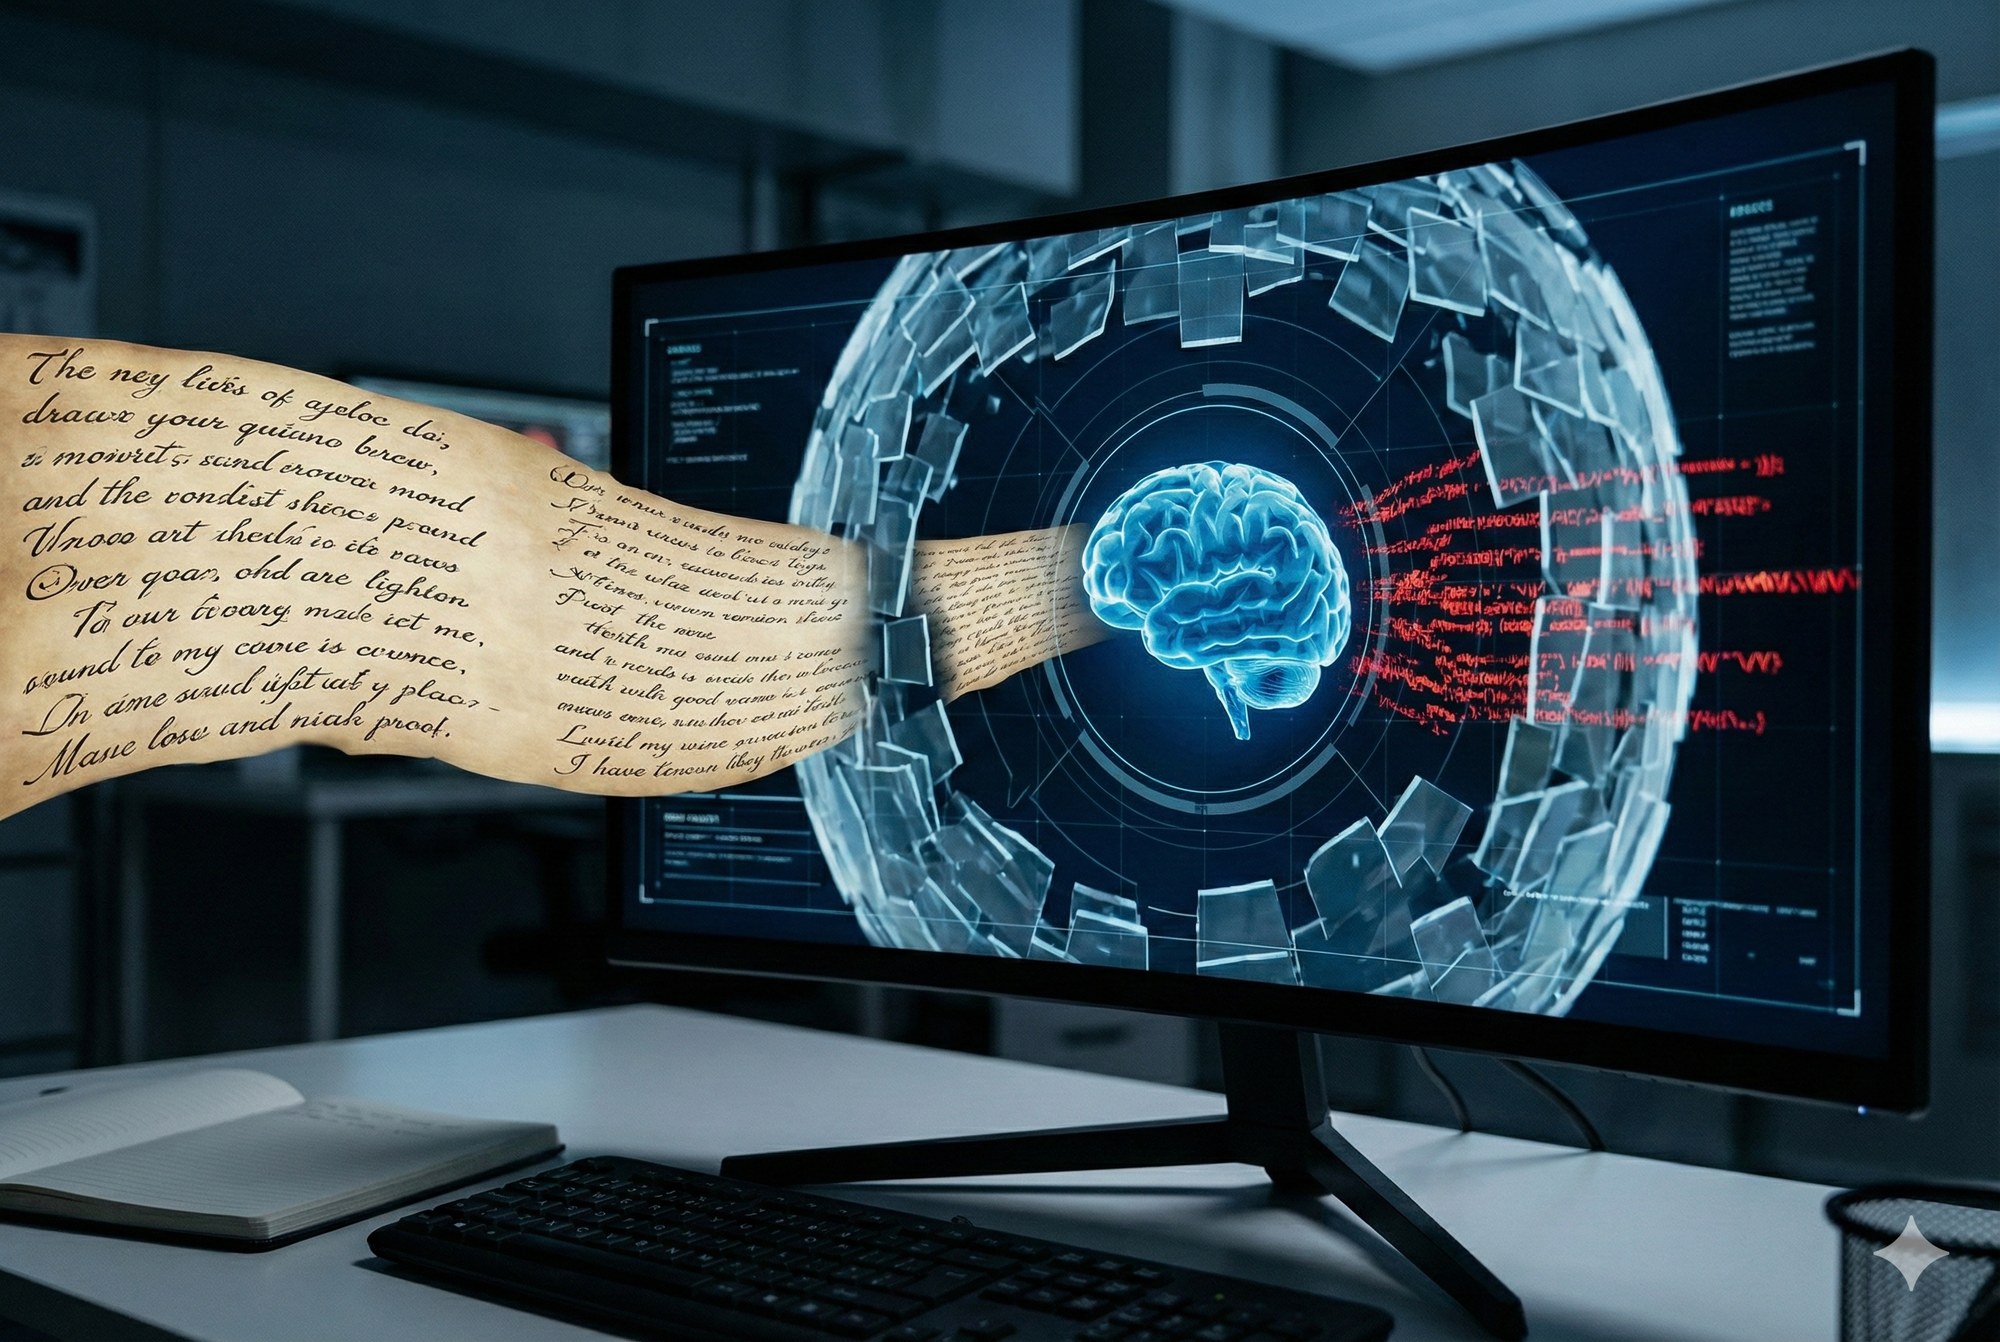
Nowym wyzwaniem dla bezpieczeństwa są techniki wykorzystujące strukturę języka zamiast manipulacji kodem, określane jako adversarial poetry. Polegają one na przekształcaniu szkodliwych zapytań w alegorie lub metafory. Przykładowo, instrukcja budowy broni może zostać sformułowana jako prośba o skomponowanie symfonii.
Model, podążając za logiką literacką, generuje treść, którą w bezpośredniej formie musiałby zablokować. Bartłomiej Anszperger podkreśla, że jest to fundamentalna zmiana charakteru zagrożeń, ponieważ atak odbywa się na poziomie znaczeń i kategorii pojęciowych. Model nie zostaje zhakowany w tradycyjnym sensie, lecz pozostaje przekonany, że realizuje bezpieczne zadanie.
Perspektywy ochrony w systemach autonomicznych
W dobie rozwoju agentów AI odporność na manipulację językową staje się kluczowym elementem bezpieczeństwa organizacji. Jak podaje serwis F5 Labs, obecnym wyzwaniem jest stworzenie rozwiązań, które będą rozumiały ogólne koncepcje, a nie tylko powtarzalne wzorce.
Firma F5, zajmująca się zabezpieczaniem aplikacji i API w środowiskach chmurowych i hybrydowych, wskazuje na konieczność działania systemów obronnych w trybie ciągłym, ponieważ nowe klasy ataków pojawiają się obecnie w odstępach dni, a nie miesięcy. Kluczowym pytaniem dla projektantów systemów pozostaje to, jak model zachowa się w sytuacji, gdy użytkownik spróbuje wpłynąć na jego sposób rozumowania.