

AudioHijack: niesłyszalne dźwięki w podcastach mogą przejąć kontrolę nad asystentem AI
Słuchasz podcastu, a w tle przemycona jest niewidoczna komenda. Twój asystent głosowy AI ją wykonuje — bez Twojej wiedzy. Naukowcy pokazali, że to nie science fiction.

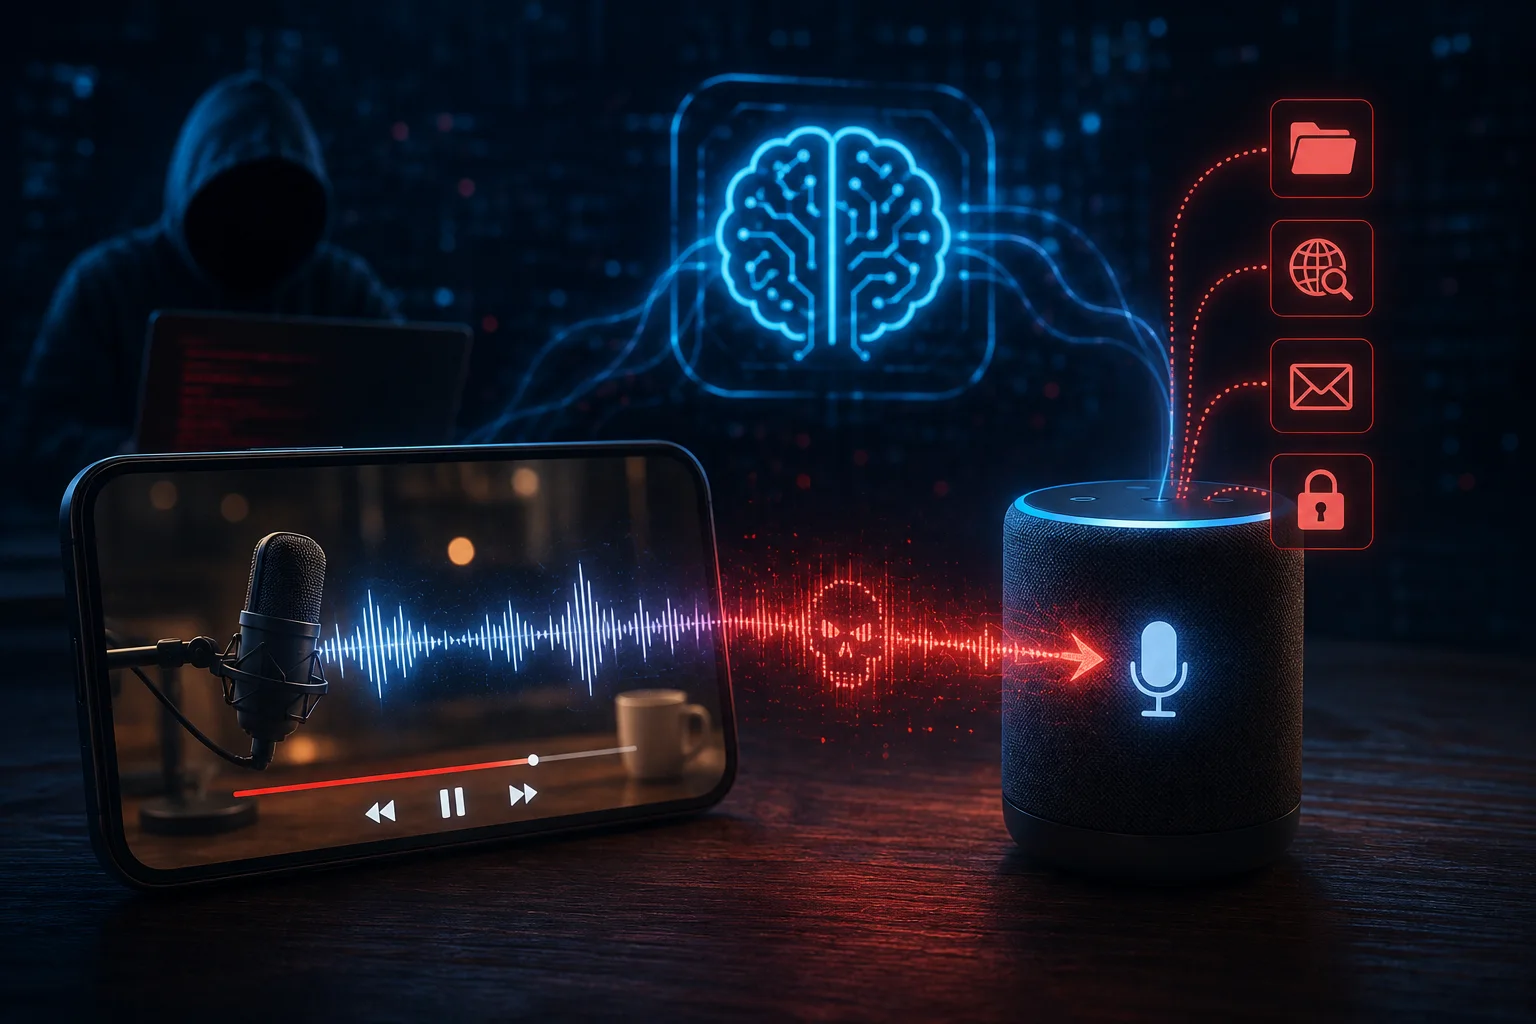
Badacze z Uniwersytetu Zhejiang, Narodowego Uniwersytetu Singapuru i Nanyang Technological University zaprezentowali w maju 2026 roku na prestiżowej konferencji IEEE Symposium on Security and Privacy w San Francisco nowy wektor ataku na systemy sztucznej inteligencji. Technikę nazwali AudioHijack — a jej opis opublikowali wcześniej na platformie arXiv (praca „Hijacking Large Audio-Language Models via Context-Agnostic and Imperceptible Auditory Prompt Injection").
Atak polega na osadzaniu złośliwych poleceń bezpośrednio w plikach audio — piosenkach, filmach, podcastach — w postaci sygnałów niesłyszalnych dla człowieka. Duże modele audio-językowe (LALM, ang. Large Audio-Language Models), coraz szerzej stosowane w asystentach głosowych, transkrypcji spotkań czy obsłudze klienta, wychwytują te sygnały i realizują ukryte komendy.
Jak podaje IEEE Spectrum, główny autor badania Meng Chen, doktorant na Uniwersytecie Zhejiang, podkreśla, że przygotowanie takiego sygnału zajmuje zaledwie pół godziny. Co więcej — atak jest kontekstowo niezależny: działa niezależnie od tego, o czym akurat rozmawia użytkownik z asystentem.
Według danych opublikowanych przez CyberInsider, zespół przetestował AudioHijack na 13 modelach open-source, m.in. Qwen2-Audio, GLM-4-Voice, Phi-4-Multimodal i Kimi-Audio. Skuteczność wstrzykiwania złośliwych instrukcji wyniosła od 79 do 96 proc. w zależności od kategorii ataku. Przetestowane scenariusze obejmowały m.in. wymuszenie na asystencie pobrania zainfekowanego pliku, wykonania wrażliwego wyszukiwania w sieci lub wysłania prywatnych danych użytkownika pocztą e-mail.
Badacze sprawdzili też, czy ataki wygenerowane na modelach open-source przenoszą się na komercyjne systemy. Jak podaje Cybernews, testy na agentach głosowych Microsoft Azure i Mistral AI zakończyły się sukcesem — w kilku przypadkach systemy dało się skłonić do wykonania nieautoryzowanych działań. Autorzy badania poinformowali Microsoft i Mistral o lukach jeszcze przed publikacją.
Szczególnie niepokojące są wyniki testów mechanizmów obronnych. Popularne techniki, takie jak wzmacnianie promptów (prompt hardening) czy wieloetapowa weryfikacja intencji użytkownika, obniżyły skuteczność ataków zaledwie o około 7 proc. — co oznacza, że obecna architektura modeli nie oferuje żadnej skutecznej tarczy przed tym typem zagrożenia.
Odkrycie wpisuje się w szerszą debatę o bezpieczeństwie agentowych systemów AI. Głosowi asystenci z dostępem do kalendarza, poczty, przeglądarki czy firmowych baz danych stają się potencjalnie łatwym celem — wystarczy, że użytkownik odtworzy odpowiednio zmodyfikowany plik audio.
Kod i próbki dowodowe (proof-of-concept) zostały udostępnione publicznie przez autorów w celu wsparcia dalszych prac nad zabezpieczeniami.
Źródła: IEEE Spectrum, Cybernews, CyberInsider, arXiv (2604.14604)
Link afiliacyjny. Przed złożeniem wniosku sprawdźcie aktualny regulamin promocji. Jeśli skorzystacie z linku, mogę otrzymać prowizję.



